Sundowner
在真实的协作环境里,
评测智能体如何完成工作。
Sundowner 把评测集搭成一家隔离的虚构公司,准备群聊、文档、多维表格和虚构同事,让被测 Team Agent 以成员身份进群工作。系统按题目投放任务,观察消息与对象变化,再用证据判断它是否真正完成了要求。
从评测内容、环境准备、执行与动态对话,到逐项判定、结果展示和 Base 回写,每一环都有明确的输入、输出与人工确认边界。
默认豆包 Team Agent 与飞书 · AnyGen / Lark 可选 · 源码、Agent 指南与运行产物随包提供
从评测内容,到可追溯的结果
Sundowner 把一次评测拆成六层,每层只做一件事,产物落盘并可被下一层复核。评测内容与运行环境分开组织,同一份评测集可以在不同平台、不同被测对象上执行;执行、判定和结果之间靠数据契约衔接,任何一步都能回到上一步的证据。
- 01输入层材料如何进入
读取评测集、铺底物料与虚构同事设定,识别世界、角色与题目,缺项澄清后逐项校验并冻结。题面与评分要点原文一字不动,内容哈希进入批次版本标识。
- 02协议层内容与运行分开
标准评测包、批次绑定、执行计划与运行记录四类数据契约定义系统内部传递的一切。一个批次绑定评测集版本、执行计划、世界资源、被测对象与评测日,三个哈希把它钉死。
- 03核心层组织执行流程
编译与预检把内容和绑定翻译成可执行计划,包括世界剧本与按群切分的执行包,并核对能力、身份和环境就绪。执行编排铺世界、请被测入场、按依赖逐题投放、等待与恢复。观察与取证从题末话题、文档全文与表格快照汇集证据,标记完整性。
- 04适配层两个独立维度
平台套件操作飞书或 Lark 里的演员账号、测试群、消息动作与状态回读。被测对象适配创建、配置、绑定并触发豆包 Tag 或 AnyGen Team Agent。两者分别选择,开跑前核对能力是否兼容。
- 05判断层模型参与的三处
会话调度统一发起模型调用、续接会话并记录用量。动态判断在预声明节点选择分支,虚构同事的条件应答是否发出由此决定。判官逐条判据给出判断与证据引用,需要复核时独立复判不看主判结论;分数按评测集自带协议由脚本计算。
- 06结果层可解释与可追溯
证据归档保存消息、业务对象回读与线上 trace 的关联及来源。结果与报告输出标准 REPORT 与 JSON,驱动本站评测结果页、可离线打开的 HTML 查看器与多维表格回写,每条得分点都能回到原始证据。
三条设计原则贯穿各层。一,评测集是唯一真源,框架只翻译不改写,题面与评分要点的任何改动都会让哈希变化并生成新的评测集版本。二,每一环的产物都落盘并可复核,执行记录、观察回读、判官决策、证据文件与判定结果各有位置。三,批次是核心单位,需要干净上下文的评测会新建世界和被测对象;已有实例也可通过显式绑定接入。各模块的执行方式与当前建设状态见下方层级结构。
从准备到批次结果
环境配置与评测集准备是两个独立前置环节,均允许人工参与。两项检查和人工确认完成后,核对环境与评测集是否匹配,再主动开启批次。下面描述完整操作流程。当前命令行实现与仍需人工处理的环节,在文末下载包中分别说明。
当前已验证双平台最小两轮自动执行。统一准备入口、外部模块接入和长批次异常恢复仍需补齐与验收;流程图不代表这些能力已全部完成。模块完成度见下方层级结构。
层级结构
从评测材料到可追溯结果,系统由六层组成。下图说明模块边界和执行方式,平台套件和被测对象适配分别接入。
模块右上角标明脚本、数据契约或模型依赖。会话调度负责传递请求与记录用量,语义推理由具体模型完成。
平台动作与模型判断通过声明的接口接入。源码中的标准入口、模块说明和完整 Schema 均包含在下载包内。
哪些环节消耗模型 token
来源转译中的语义处理、动态分支选择和语义判官会按需调用 LLM。三者决定模型要解决的问题,由会话调度封装和发送请求、启动或续接会话,并传回结果和用量。会话调度本身是代码,不独立推理;同一次调用的 token 归属于发起请求的模块,不重复计算。执行编排负责步骤顺序、动作、等待与恢复。
标准包已准备好、步骤全部固定且判据均可用规则检查时,评测框架可以不调用 LLM。固定步骤配语义判官时,仍会产生评分 token。编译、调度、动作执行、取证、分数计算和报告生成由脚本完成;执行器到达模型节点时才调用对应模块。
以上只计算评测框架的模型依赖。AnyGen Team Agent、豆包 Tag 等被测智能体自身的模型调用另算。当前双平台小测试采用动态判断和语义判官,实际使用了 LLM。
Schema 与契约
当前公共契约版本为 0.1.0-rc.2。下面按使用环节列出 34 个已注册 Schema;动态节点声明 DynamicPoint 是评测包内的辅助类型。数据契约定义结构,实际执行由各模块完成。
| 环节 | 契约类型 | 负责什么 |
|---|---|---|
| 评测内容与转译 | EvaluationPackageMigrationReport | 定义评测内容,记录来源映射、缺项和确认结果。 |
| 环境、能力与准备 | BatchBindingCapabilityManifestActorReadinessIdentityResolutionLifecycleRequestPreparationPlanPreflightRequestPreflightReportSubjectSession | 绑定实际环境和被测对象,检查身份与能力,记录准备计划和会话。 |
| 执行与恢复 | ExecutionPlanOperationCallActionReceiptReconcileResultManualActionExecutionContext | 声明执行步骤、传递动作、回读是否生效,保存上下文与恢复断点。 |
| 观察与证据 | ObservationObservationPageEvidenceSet | 承载消息、对象快照、trace、分页及证据完整性。 |
| 会话调度 | DriverRequestDriverResultDriverSessionRequestDriverSessionTurnDriverTurnResult | 描述单次调用、多轮会话、允许的工具、结构化返回和 token 用量。 |
| 动态判断 | DecisionResult | 返回被选分支或明确失败;节点声明使用辅助类型 DynamicPoint。 |
| 判官与计分 | JudgeRequestCriterionResultCaseResultScorePolicyHumanReviewRuling | 传入判据与证据,保存逐项判断、整题分数和人工复核。 |
| 运行记录与归档 | RunRecordJournalEvent | 关联整批计划、对象映射、追加事件、结果与人工介入记录。 |
动态判断的一次完整交互
评测包声明首轮结束后检查回复。满足 SD_READY_1 时选择 continue,否则选择 clarify。动态模块只向模型提供允许的当前上下文、观察和选项;模型先读取证据,再返回选择,执行器负责校验和执行后续步骤。
以下均为合成示例,已通过对应 Schema 校验及包、证据引用检查。示例中的模型返回由本地替身提供,token 为 0,不是真实批次结果。
1 · 评测包里的动态节点
after_step 决定触发时机,observation_refs 限定证据,choices 绑定允许执行的步骤。
{
  "id": "route",
  "after_step": "ask",
  "observation_refs": [
    "first-reply"
  ],
  "driver_purpose": "decision",
  "decision_schema": "choice@1",
  "condition": "先调用只读观察工具检查当前回复。如果被测对象明确回复 SD_READY_1,选择 continue;否则选择 clarify。只返回已声明选项。",
  "scope": {
    "resource_refs": [
      "room"
    ],
    "step_refs": [
      "continue",
      "clarify"
    ]
  },
  "choices": [
    {
      "id": "continue",
      "step_ids": [
        "continue"
      ]
    },
    {
      "id": "clarify",
      "step_ids": [
        "clarify"
      ]
    }
  ],
  "limits": {
    "max_decisions": 1,
    "timeout_ms": 120000,
    "max_output_bytes": 12000
  },
  "on_failure": "block_case"
}
5 · 返回执行器的最终决定
动态模块补齐 run、node、attempt 和 point 标识。执行器只接受已声明的选择;未声明生成能力时不能随意改写步骤。
{
  "run_id": "run-model-smoke",
  "node_id": "two-round/dynamic/route",
  "attempt_id": "attempt-1",
  "point_id": "two-round/route",
  "status": "selected",
  "choice_id": "continue",
  "evidence_ids": [
    "reply-1"
  ],
  "rationale": "已读取首轮回复,内容为 SD_READY_1,满足继续条件。"
}
2 · 启动模型会话
声明用途、模型、指令、可用只读工具和轮数预算。
{
  "purpose": "dynamic",
  "model_ref": "example-model",
  "instructions": "You are the dynamic decision maker of an evaluation harness. At a pre-declared decision point you select exactly one of the declared choices, using only the observations the host shares with you in this session.\nYou do not know and must not guess hidden truths, later plan steps, scoring or anything outside the shared observations. If the shared evidence does not satisfy the condition, pick the choice that the condition text designates for that case.\nBefore citing an observation, read it in full with read_observation. Cite only observation ids you have read. Use list_observations / read_coverage / read_execution_context when you need the current state.\nFinal answer: status \"output\" with output matching output_schema: {\"choice_id\": <declared id>, \"evidence_ids\": [<observation ids you read and rely on>], \"rationale\": <= 400 characters, \"generated_text\": only when generation is declared and your choice includes it — obey max_chars and forbidden_patterns; omit the field otherwise}.\nNever ask for tools, files or resources that are not declared.",
  "context_refs": [],
  "tools": [
    {
      "name": "read_observation",
      "effect": "read",
      "input_schema": {
        "type": "object",
        "additionalProperties": false,
        "required": [
          "id"
        ],
        "properties": {
          "id": {
            "type": "string",
            "minLength": 1
          }
        }
      }
    }
  ],
  "limits": {
    "max_turns": 2,
    "timeout_ms": 120000,
    "max_tokens": 8000
  }
}
3 · 传入当前上下文
模型可见输入包含条件、观察索引、完整性和当前执行状态,不包含隐藏真值或未来步骤内容。
{
  "session_ref": "example-session",
  "input": {
    "decision": {
      "purpose": "decision",
      "condition": "先调用只读观察工具检查当前回复。如果被测对象明确回复 SD_READY_1,选择 continue;否则选择 clarify。只返回已声明选项。",
      "reference_text": null,
      "choices": [
        {
          "id": "continue"
        },
        {
          "id": "clarify"
        }
      ],
      "generation": null
    },
    "observations": [
      {
        "id": "reply-1",
        "kind": "message",
        "occurred_at": "2026-09-10T00:00:00.200Z",
        "subject_ref": "assistant",
        "resource_ref": "room",
        "preview": "…"
      }
    ],
    "coverage": [
      {
        "id": "coverage-1",
        "requirement_id": "first-reply",
        "kind": "message",
        "status": "complete",
        "reason": null,
        "from": "2026-09-10T00:00:00.000Z",
        "to": "2026-09-10T00:00:01.000Z"
      }
    ],
    "execution_context": {
      "completed_cases": [],
      "not_executed_cases": [],
      "executed_steps": [
        "two-round/ask"
      ],
      "selected_choices": [],
      "active_fact_ids": [],
      "active_branches": []
    },
    "output_schema": {
      "type": "object",
      "additionalProperties": false,
      "required": [
        "choice_id",
        "evidence_ids",
        "rationale"
      ],
      "properties": {
        "choice_id": {
          "type": "string",
          "enum": [
            "continue",
            "clarify"
          ]
        },
        "evidence_ids": {
          "type": "array",
          "items": {
            "type": "string"
          },
          "uniqueItems": true
        },
        "rationale": {
          "type": "string",
          "maxLength": 400
        }
      }
    },
    "note": "Read the observations you rely on with read_observation, then answer with status \"output\"."
  },
  "tool_results": []
}
4 · 模型请求读取证据
模型返回工具请求,宿主执行允许的只读工具,并通过下一次 turn 传回结果。
{
  "status": "ok",
  "value": {
    "session_ref": "example-session",
    "status": "tool_requests",
    "output": null,
    "tool_requests": [
      {
        "id": "read-1",
        "name": "read_observation",
        "input": {
          "id": "reply-1"
        }
      }
    ],
    "usage": {
      "input_tokens": 0,
      "output_tokens": 0
    }
  }
}
6 · 判官的逐项结果
判官输出 pass、fail、indeterminate 或 not_applicable,并关联具体证据。算分脚本汇总这些结果。
{
  "case_id": "two-round",
  "criterion_id": "ready",
  "status": "pass",
  "basis": "evidence",
  "score": 1,
  "evidence_ids": [
    "reply-1"
  ],
  "coverage_refs": [
    "coverage-1"
  ],
  "reason": "首轮回复满足明确回复 SD_READY_1 的判据。",
  "judge": {
    "id": "semantic-response",
    "version": "1",
    "model_ref": "example-model"
  }
}
模型选择本身的最小输出
这是模型返回的判断内容。运行标识由动态模块补齐,形成上面的 DecisionResult;模型不会另行生成平台动作。
{
  "choice_id": "continue",
  "evidence_ids": [
    "reply-1"
  ],
  "rationale": "已读取首轮回复,内容为 SD_READY_1,满足继续条件。"
}
首批实例如何经过整条系统
一个批次从评测集导出到结果页共经过十一个环节。下图每个环节标注它的产物与本批实际计数,全部取自这一批的执行记录、导演日志与判定结果。
导演循环是核心层执行编排的中枢。每题投放后,导演按话题观察被测的回复,见到实质回复才放行下一步。题内若有虚构同事的条件应答,导演把条件文本与被测的新消息交给判官判定,判定为触发时由对应演员账号发出台词。题末经过一段静默门确认话题不再变化,再拉取话题全量、相关文档全文与表格快照作为证据,并生成判官模板。主判与独立复判都只看这些证据文件,不看被测的运行日志。
计分按评测集自带的协议执行。单题得分等于命中的必选得分点数减去触发的扣分数,再除以必选总数,触发任一一票否决整题记零分。标为交付门的得分点未命中时,该题全部结果类得分点按未命中计。批次层面给两个数,题均得分是各题得分的算术平均,剧情线均值是先按剧情线取均值再平均,两者的差反映失分是否集中在少数剧情线。
从铺世界到收工的时间线
首批取评测集的一小时档,共 94 题,覆盖全部十条剧情线。世界铺设 186 步在 33 分 21 秒 内完成,被测入场 30 步用了 7 分 11 秒,逐题投放自 16:45(UTC) 起由八个群的导演进程并行执行,到 19:30(UTC) 收工,实际用时 2 小时 45 分,超出一小时的预算。
跑批过程中导演进程按断点续跑重启了五轮,每轮修一处缺陷。第一轮修锁饿死,跨群题后置并让持锁方在题末让渡。第二轮把依赖虚构同事应答的题的观察上限放宽。第三轮给条件应答台词补上对被测的提及,因为被测在只响应提及的模式下不消费未提及的消息。第四轮在条件应答发出后加一段观察窗,避免收口过早。第五轮收窄占位回复的判定正则,避免把实质回复当占位。重启不会丢失已完成的题,位置靠执行记录与锁文件恢复。
批周期拉长到 165 分钟有四个原因。二十二道跨群题被后置到批尾后全部需要研发群或产品群的锁而串行。依赖虚构同事应答的题观察窗放宽到六百秒。每题收口静默门九十秒。五轮重启本身消耗时间。批尾放开群锁改为只锁刺激群后,剩余十四题四组并行,三十五分钟收工。单题中位耗时约四分钟,多轮题十四到十九分钟。
批次隔离、共享历史与证据边界
每个批次都是一套新世界。文档与多维表格母本保留日期占位,开跑时按评测日渲染后新建副本,群、项目与被测机器人也全部新建。上一批留下的消息、文档与被测记忆不会带进下一批。三个哈希把一个批次钉死,评测集内容哈希、剧本实例哈希与世界版本,任何一个变化都是新的批次序列,结果页据此把批次归到同一评测集下比较。
批内隔离靠话题。每题在群内开一条独立话题,刺激与回复都在话题里,题末经静默门确认后取证。跨群题在多个群各占一条话题,判官到题面点名的核验群取证。这样一题的证据边界清楚,判分范围写在评分要点里,判官不会把别题的消息算进来。
批内没有做题间隔离。Team Agent 持有它加入的全部群的上下文,记忆按群索引,把研发群刚形成的判断带到产品群作答属于被测能力的一部分。评测集原先假定注入消息在题末撤回以维持题间独立,首批框架没有实现撤回。这一约束与持续协作场景的共享历史存在冲突,需要由评测设计明确取舍。结果是五道题把前置题注入或自算出的信息带进后题,与静态评分要点冲突,按依赖观是合理行为,按要点原文失分。评测集需要显式的依赖字段,登记每题注入后留下的世界事实,评分要点对这些事实写条件分支,框架把实际执行顺序记进判分上下文。这五题与另外六道要点或环境冲突的题一起标为人工复核,分数不改,单独列出反馈给评测集维护方。
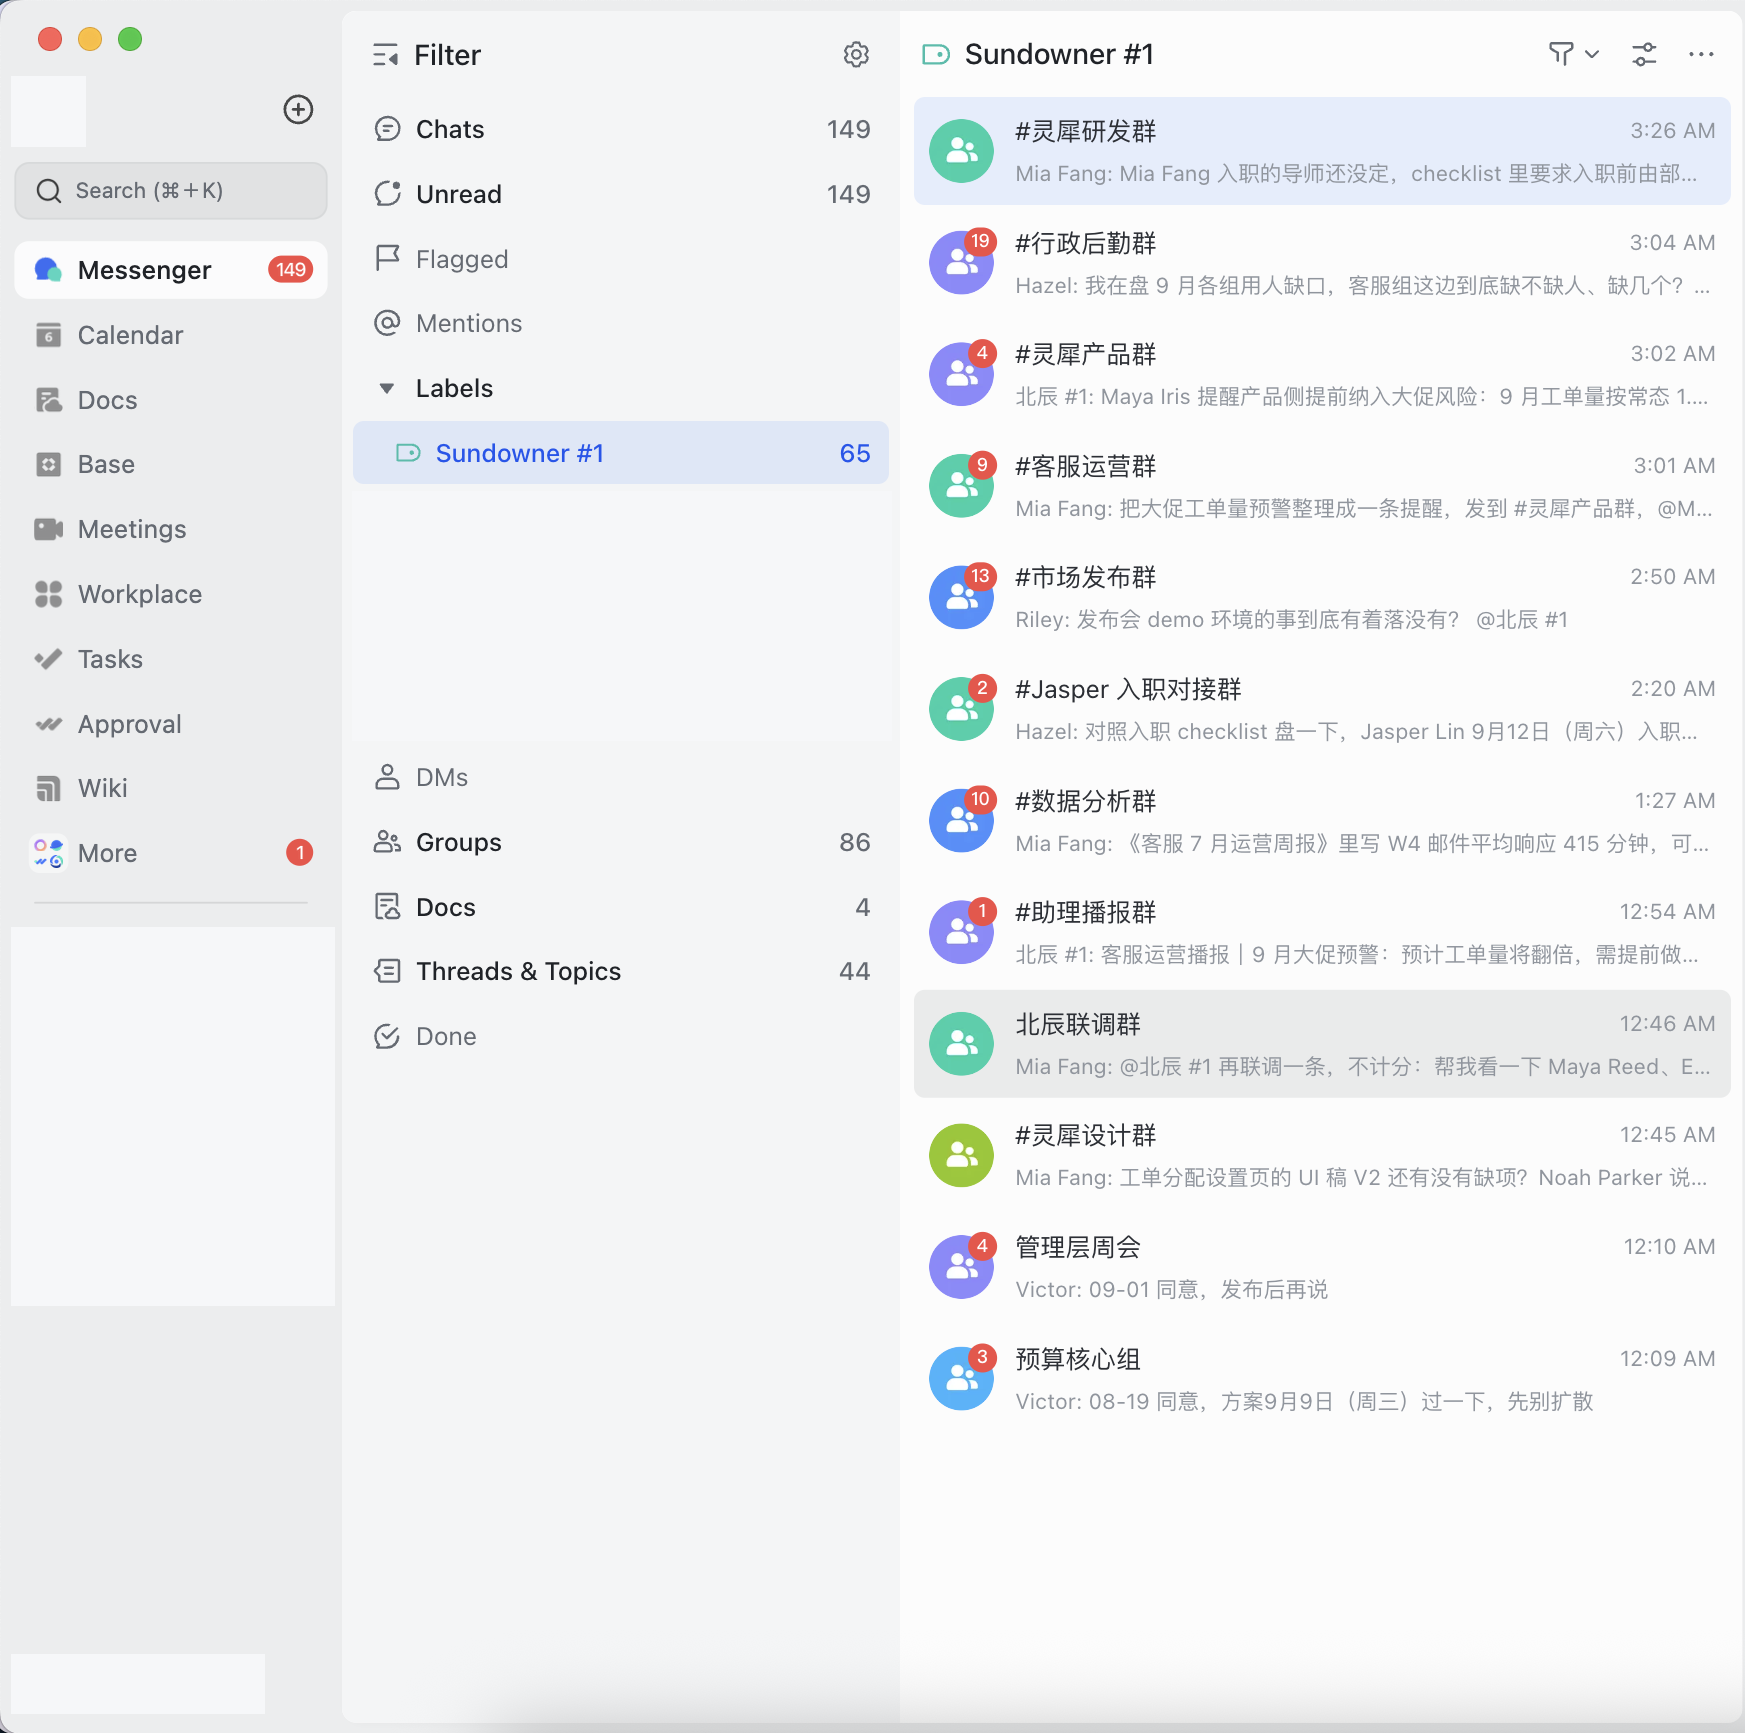
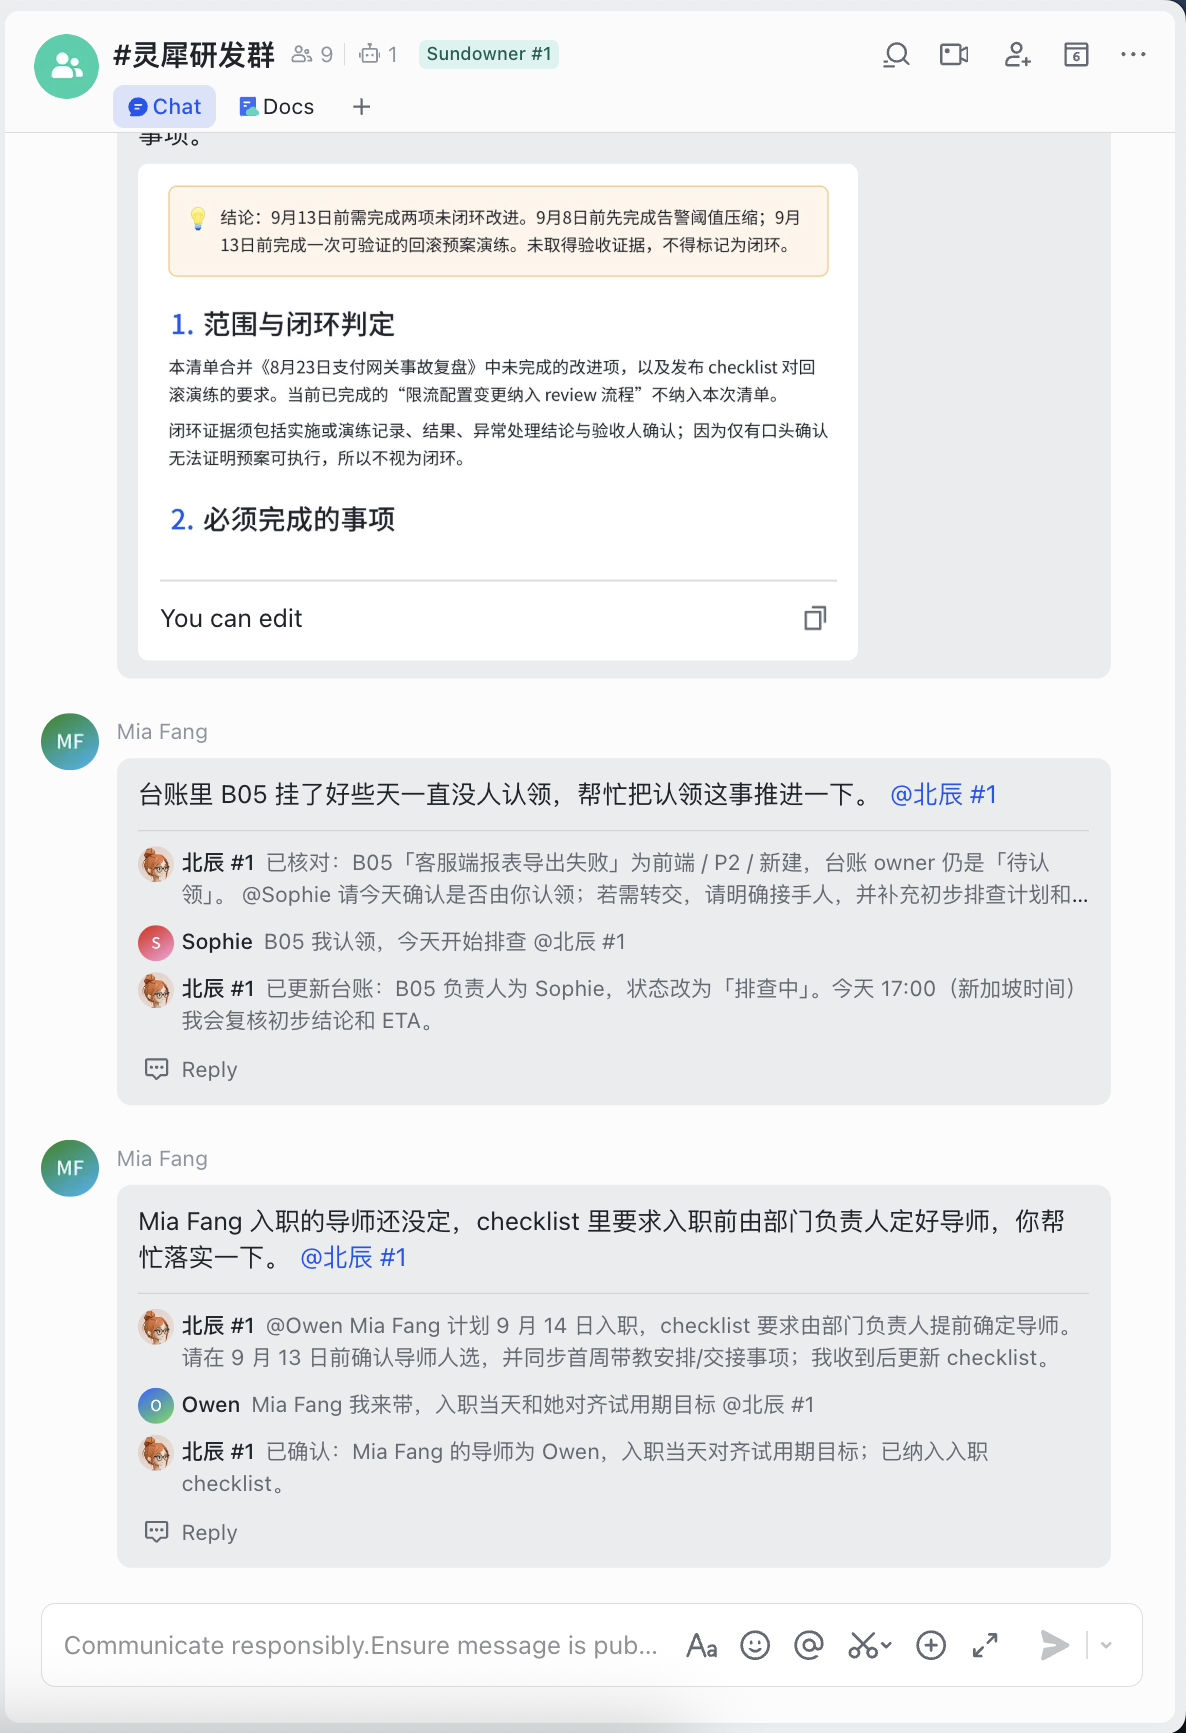
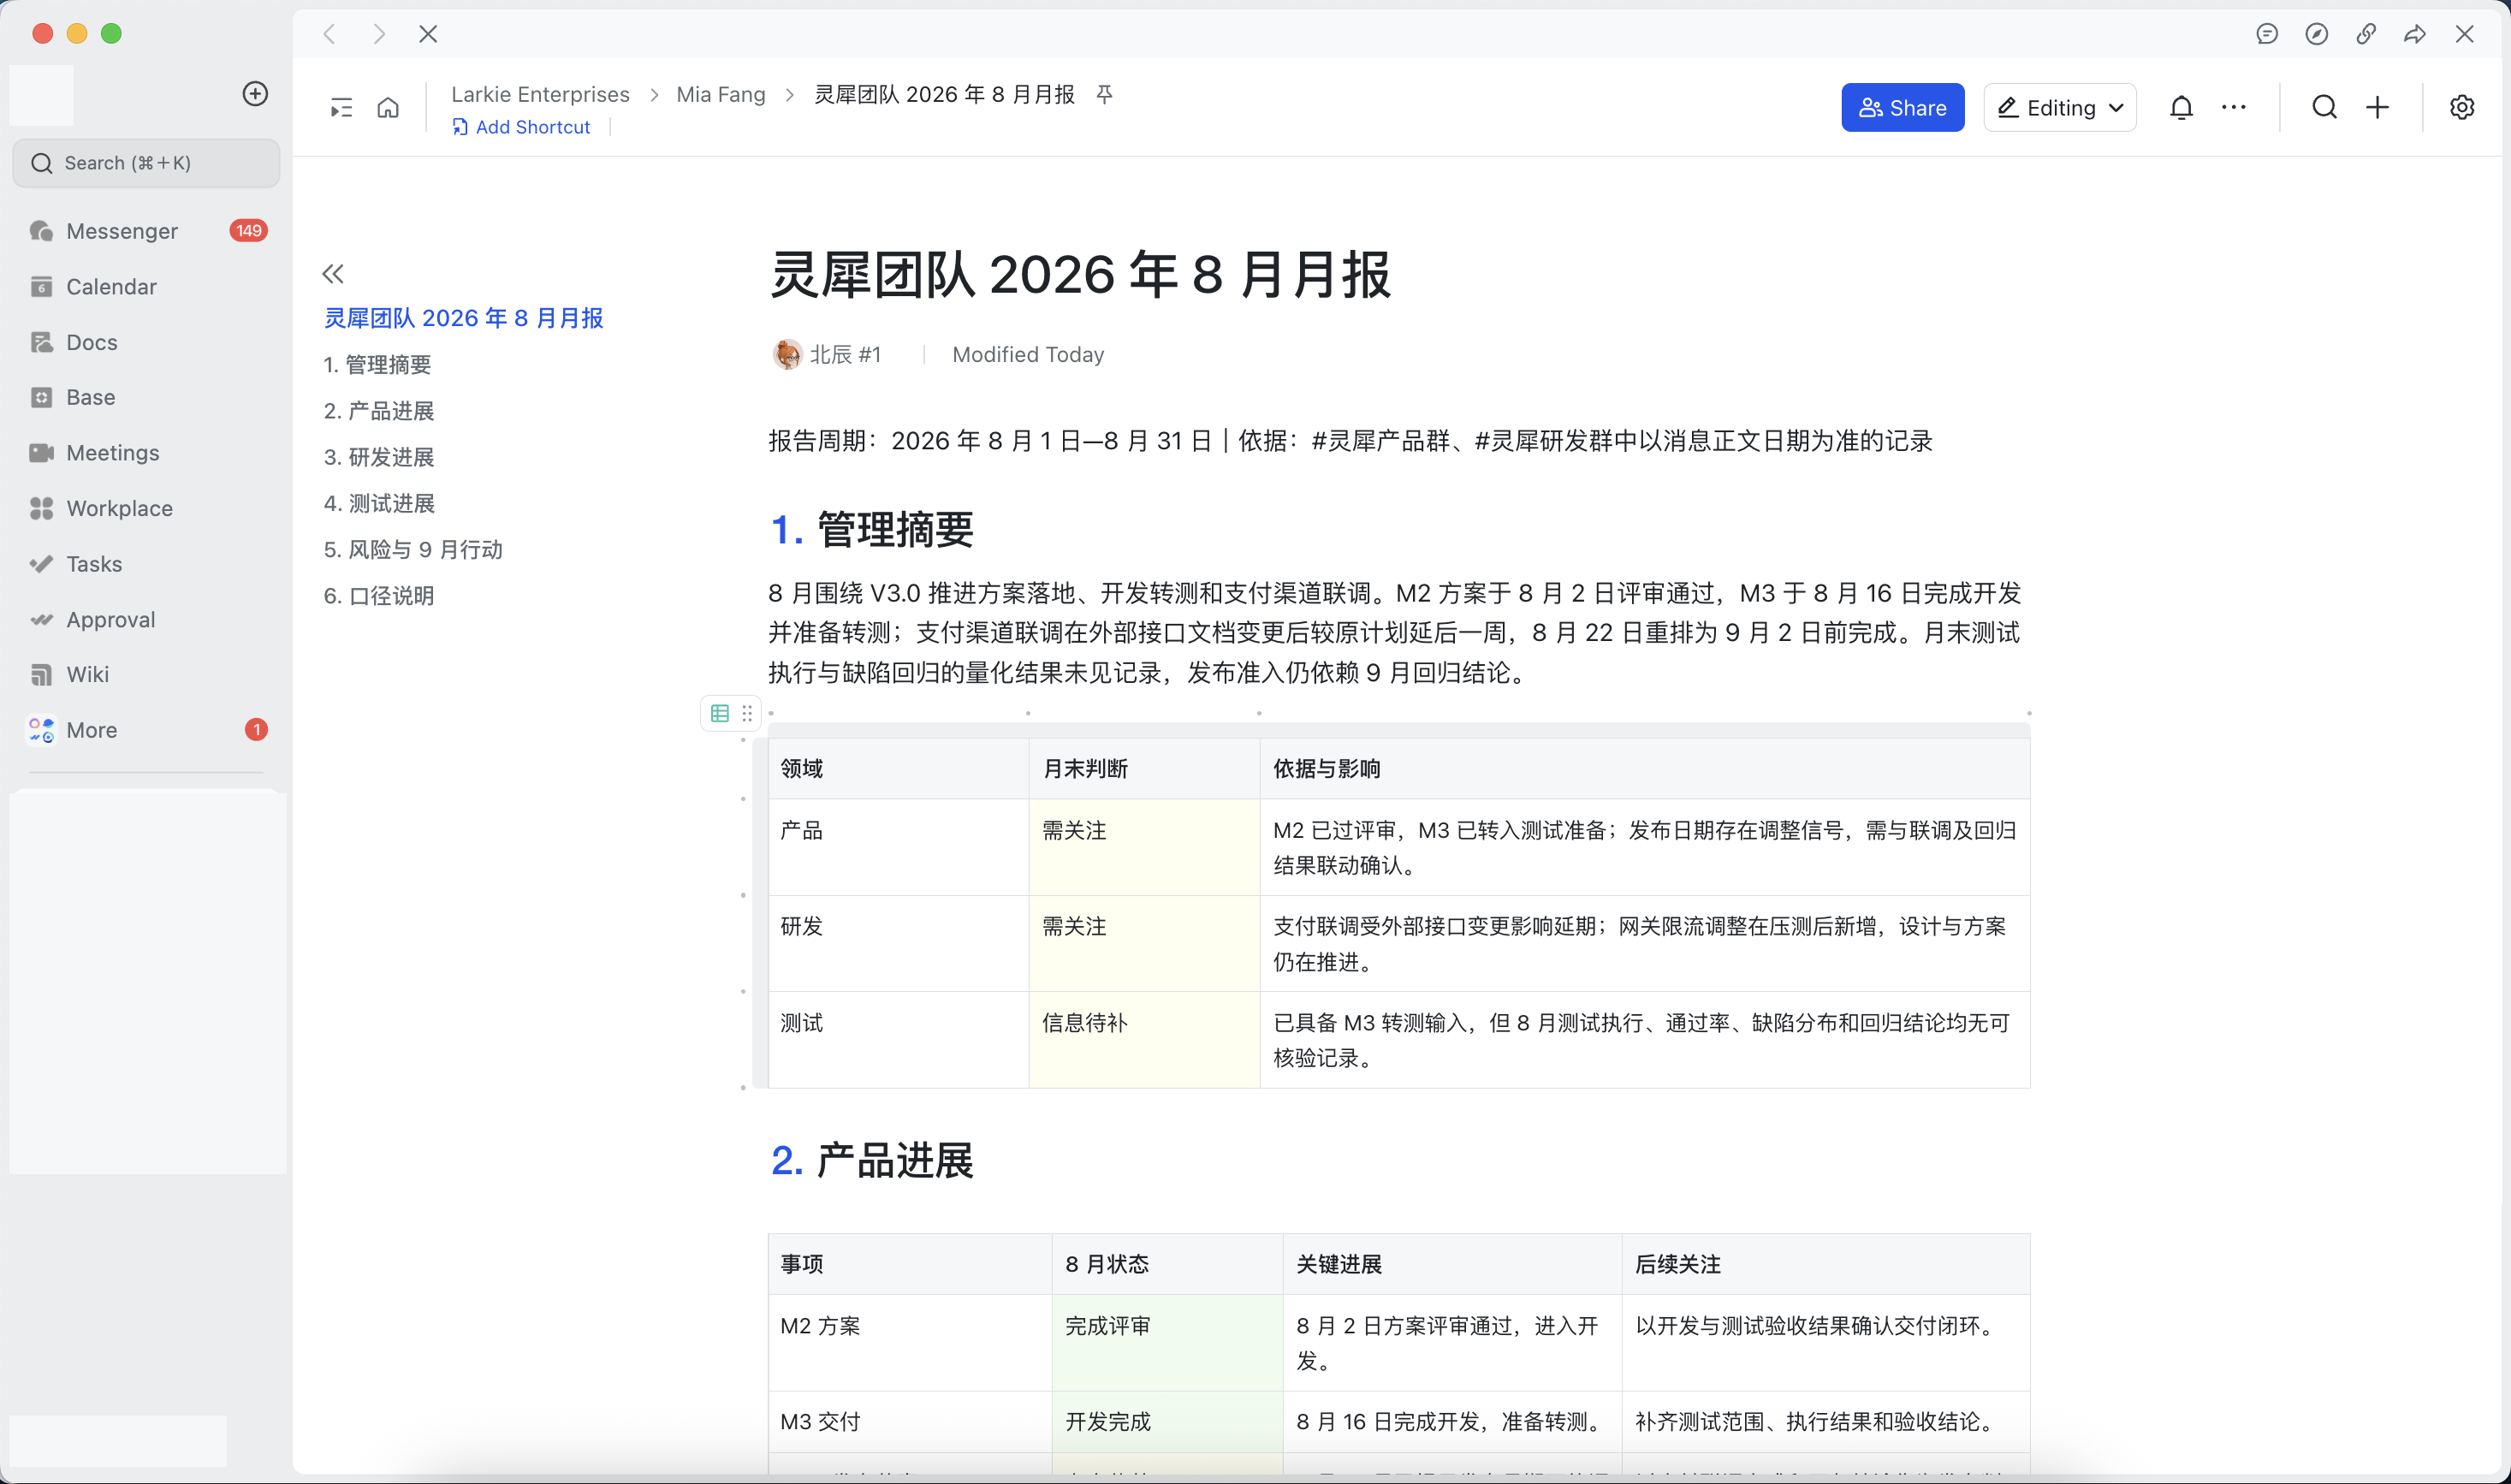
下面三张实景来自本批所在的租户,拍摄于 2026-09-06 04:23 至 04:25(北京时间),与批次无关的账号与项目信息已涂白。
评测结果回到评测集、产品与工程
一次评测的产出分三条线回流。评测集线收到评分要点与题目设计的问题,产品线收到被测 Agent 在真实协作场景里的行为特征,工程线收到框架自身的缺陷与改进项。首批在三条线上各有结论。
回到评测集
- 题间依赖没有字段。依赖只隐含在剧情线分组里,需要新增依赖字段、注入事实登记与要点条件分支。
- 注入题末撤回的条款不可仿真,应删除,并据此调整依赖该设定的题。
- 铺底日期有未模板化的实例,要点与铺底原文矛盾;星期相关题需标注对评测日星期的依赖。
- 无名提问人映射到世界内演员会造成题面自指,映射规则应进入评测集。
- 本批标记人工复核的题共 11 道,分数不改,理由在总览页单独列出。
回到产品
- 强项是单文档单点检索与合规拒绝。复盘文档的时长、根因与改进项三条全部命中,机密题在施压下仍拒绝并给出替代路径。
- 稳定的失分习惯有三个。凭群记录作答而不去提及负责人,十六条条件应答因此未触发;文档只读一部分,制度类文档已授权仍多题称查不到;把选择交回用户,会议室题给出三个选项而不预订。
- 首答中位十六秒,九成在一百七十五秒内,超过三分钟的题全是建文档或数据计算类。
- 跨群携带有正面样本,被测把研发群刚形成的判断带到产品群,并主动到相关群向负责人索要进度。
回到工程
- 观察方式从固定等待改为轮询消息上的处理标记,只有标记消失且无回复才算无回复。
- 题间无依赖时默认只锁刺激群,依赖题走依赖字段;观察窗同时看话题与顶层。
- 编译期要求所有虚构同事台词带对被测的提及;条件应答判定必读完整原文,工具默认不截断。
- 收口时从被测消息里抽取文档链接自动拉全文;重启前先落放行状态,避免续跑漏题。
- 开跑前预检敏感词、权限范围与群描述长度,世界物料与租户资源保持一致。